Googleの検索リレーションズチームは2026年10月13日、公式ポッドキャスト「Search Off the Record」で、PDFが検索でどう扱われるかを取り上げた回を公開した。マーティン・スプリット氏とジョン・ミューラー氏が、インデックスの流れとつまずきやすい点を説明している。結論として、通常はHTMLでの公開を勧めている。
背景
エピソードの題は「PDFs in Search: Indexing, AI & Pitfalls」で、公開は2026年10月13日である。Search Engine Roundtableは米国時間10月13日15時27分(日本時間10月14日4時27分)に要約を掲載した。
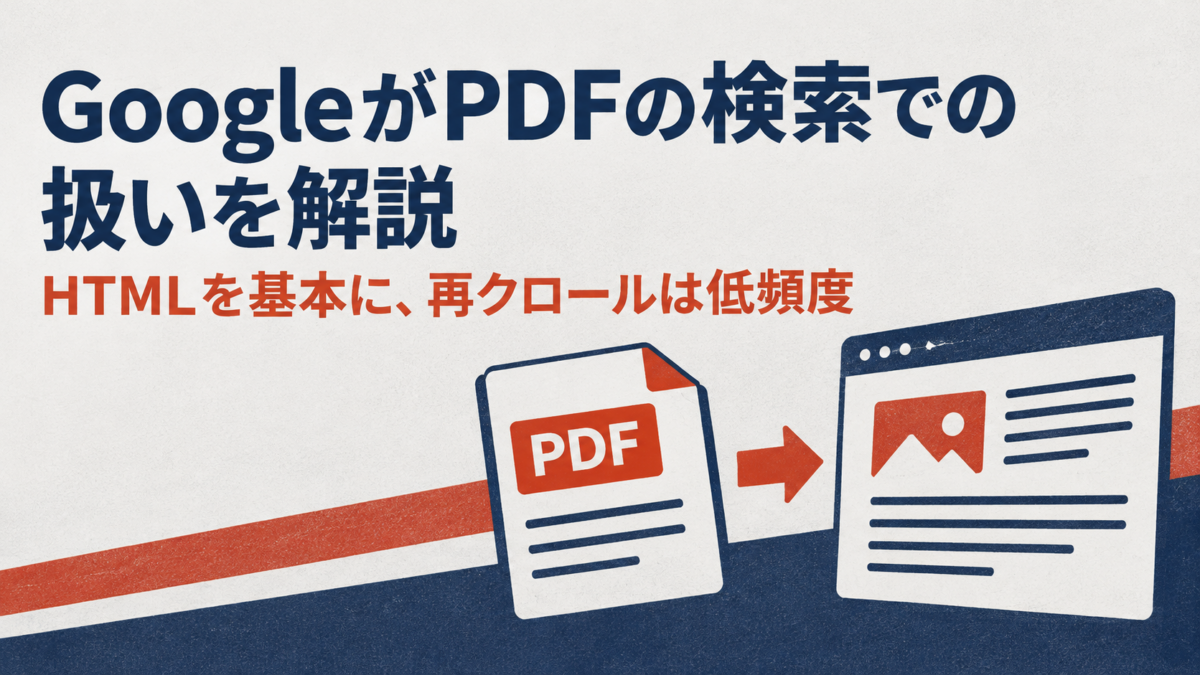
説明の軸は変換である。PDFはバイナリの入れ物で、そのままでは本文として扱えない。Googleの処理では、インデックスの段階でHTML相当に変換される。変換後は通常のページと同じ仕組みで順位がつき、AIによる回答の根拠にも使われ得る。PDF内のテキストのリンクはたどられる。一方、PDF内の画像は単独のURLを持たないため、通常の画像検索には出にくい。
つまずく箇所も挙がっている。スキャンして画像にしたままのPDFは、文字を取り出すためにOCRが要る。パスワードをかけたPDFは読み取れない。同じPDFが複数のドメインに置かれると、どれを正とするかの判断が難しくなる。rel=”canonical”をHTTPヘッダーで示す、メタデータを埋める、サイト本体へのリンクを目立たせるといった対処が挙げられている。CMSがページから自動で作る印刷用PDFが、元のHTMLと競合する例も示された。
事業者への影響
ECと店舗のサイトでPDFが多いのは、商品カタログ、仕様書、取扱説明書、価格表、飲食店のメニューである。ここで効くのが再クロールの頻度である。PDFはHTMLより取り直される間隔が長いとされる。価格や仕様を差し替えても、検索結果に古い内容が残る時間が長くなる。更新を早く反映させたい場合は、新しいURLかファイル名を使う手がある。
利用者側の使い勝手も分かれる。PDFはスマートフォンでは全体を読み込む必要があり、拡大しても文字が折り返さない。読み上げソフトでも扱いにくい。紙に印刷する前提の体裁が要る場合や、記入して提出する書類ならPDFが向くが、読んでもらうための情報はHTMLのほうが扱いやすい。
次の点を見直したい。
- 価格や仕様のように変わる情報は、PDFだけで持たずHTMLのページも用意する
- PDFを差し替えたとき、ファイル名を据え置いていないかを確認する
- スキャンしたままのPDFは、本文を選択してコピーできるかで判別する
- CMSが自動で作る印刷用PDFが、元のページと競合していないかを見る
- 卸向けの価格表など、見せたくないPDFの公開状態を確認する
今後の見通し
クロールできるファイルサイズの上限について、Googleは正確な値を公表していない。Search Engine Roundtableは、PDFの上限はHTMLより大きいとしつつ、しきい値は変わり得るため公表されていないと伝えている。本紙は具体的な数値を確認していない。
説明の多くは、以前から知られていた挙動の整理である。新しい方針が示されたわけではない。ただしAIによる回答の根拠にPDFが使われ得ると改めて述べられた点は、社内にPDFの資料が多い事業者には確認の材料になる。扱いが今後変わるかどうかは示されていない。
出典
- Google Search Off the Record「PDFs in Search: Indexing, AI & Pitfalls」(2026年10月13日公開):https://search-off-the-record.libsyn.com/pdfs-in-search-indexing-ai-pitfalls
- Search Engine Roundtable「Google Search On PDFs: Conversion, Links, HTML, Ranking, Limits, Crawling & Pitfalls」(米国時間2026年10月13日15時27分掲載):https://www.seroundtable.com/google-search-on-pdfs-42291.html