Appleが、クローラーに関する公式ドキュメントを更新し、AI学習用のユーザーエージェントであるApplebot-Extendedをrobots.txtで拒否しても、Apple検索の順位には反映されないと明記した。ドキュメントの表示は2026年9月4日公開である。検索業界紙は9月7日(米国時間)にこの記載を報じた。生成AIへの学習利用を断りたい事業者が、検索流入への影響を切り離して判断できるようになる。
背景
Appleのクローラーは2種類ある。Applebotは、SpotlightやSiri、Safariの検索機能を支えるためにページを巡回する。Applebot-Extendedは、巡回して得たデータをAppleの基盤モデルの学習に使うかどうかを制御するための指定である。ドキュメントによると、Applebot-Extended自体はページを巡回しない。
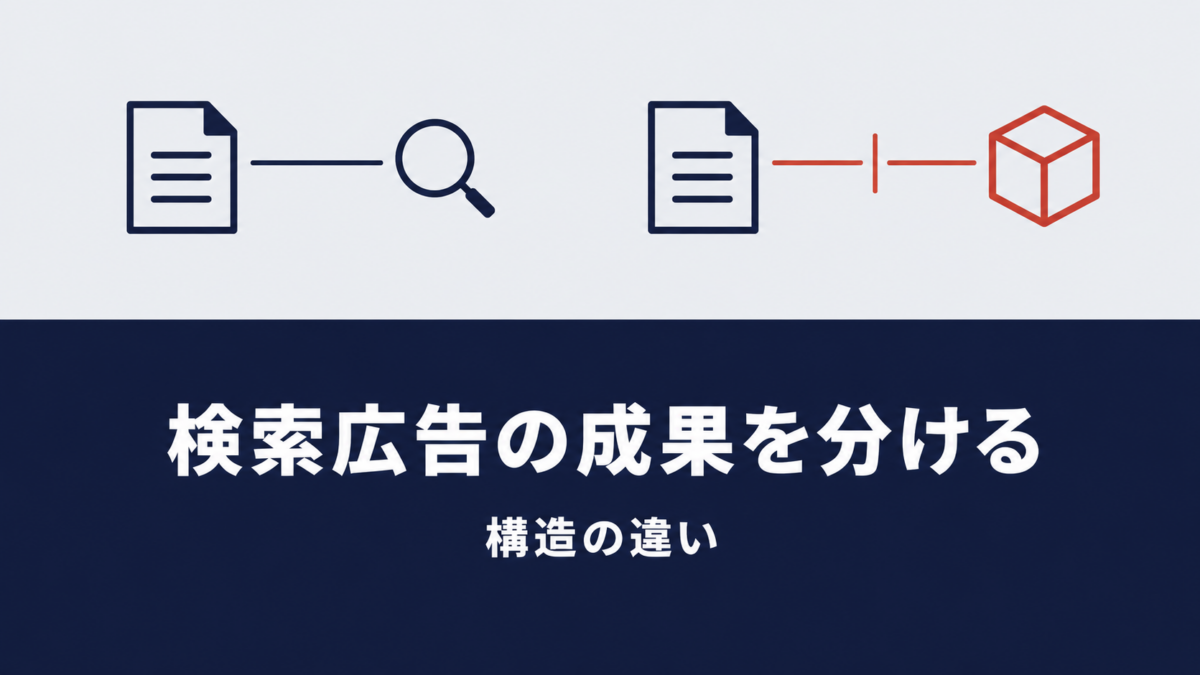
今回加わったのは、この指定と検索順位の関係を切り分ける記述である。ドキュメントは、Applebot-Extendedに対するサイト側のルールは検索の順位付けで考慮されない旨を記している。あわせて、Applebot-Extendedを拒否したページも検索結果に含まれうるとしている。
同じ構造は、Googleが検索用のGooglebotとAI学習用のGoogle-Extendedを分けている点にも見られる。学習利用の可否と、検索インデックスへの掲載を別の設定で扱う考え方が、複数の事業者で共通してきた形である。
事業者への影響
第一に、判断の切り分けができる。自社の商品説明やレビュー、独自のコンテンツをAIの学習に使われたくないという理由でクローラーを拒否したとき、Apple検索からの流入が落ちるのではないかという懸念が、公式の記述で否定された。学習利用の可否は、検索の話とは別の判断として扱える。
第二に、robots.txtの棚卸しである。AI関連のクローラーは種類が増えている。自社のrobots.txtを開いて、次の点を確認したい。
- どのユーザーエージェントを、いつ、何の理由で拒否したかが記録されているか
- 検索用のクローラーとAI学習用のクローラーを取り違えて拒否していないか
- 拒否の範囲がサイト全体か、特定のディレクトリかを把握しているか
第三に、学習の拒否と回答での引用は別の話である点だ。学習用クローラーを拒否しても、生成AIが検索を通じてページを参照し、回答内で引用する経路まで止まるとは限らない。AI検索での露出を減らしたい場合は、検索側の設定を別途確認することになる。GoogleについてはSearch Consoleに生成AI機能への掲載可否の設定があり、本紙は8月31日の全世界展開を報じている。
第四に、社内の合意形成だ。AIへの学習利用を断るかどうかは、法務や商品部門の関心事でもある。検索流入への影響がないという公式の記述は、判断を前に進める材料になる。
今後の見通し
Appleは、この記述を加えた理由を説明していない。SiriやApple Intelligenceの機能拡張が進むなかで、サイト運営者からの問い合わせが増えた結果とみられるが、確認はできていない。日本語版ドキュメントに同じ記述が反映されるかどうか、また他のAI事業者が同様の明記を行うかどうかも、現時点では分からない。
出典
- Apple「About Applebot」Apple サポート(表示は2026年9月4日公開):https://support.apple.com/en-us/119829
- Search Engine Roundtable「Applebot-Extended Are Not Considered In Ranking For Search」2026年9月7日:https://www.seroundtable.com/applebot-extended-search-ranking-42025.html
- Google「生成 AI パフォーマンス レポート(検索)」Search Console ヘルプ:https://support.google.com/webmasters/answer/16984139?hl=ja